01 / ENGLISH
贾维斯
我的 AI 助手。用他的嗓子说英文。
一个跑在本地显卡上的音色克隆实验。我先自己微调了一版,后来又换成不用训练的零样本方案。贾维斯的嗓子说英文,MOSS 的嗓子说中文。想先听一句,直接往下拉。
这条链路是:浏览器 → 网站服务器 → 隧道 → 我家那台 5060 Ti。一次请求生成一整段音频,不是实时流式。同一时间只处理一条,上一条还没好时会提示稍后再试。那台 5060 Ti 开着的时候这里就能用;它关着,这一块就是灰的,下面的成品样本不受影响。
我的 AI 助手。用他的嗓子说英文。
从电影公开片段克隆。用它的嗓子说中文。
复刻贾维斯的嗓子,是我很久以来的一个想法。不是要做一个产品,就是想听它用自己的声音,把一句新的话说出来。
最近偶然拿到一张 RTX 5060 Ti,这件事才算真正摆上桌面。我先自己训了一版:用 300 句素材微调 XTTS,跑满 20 个 epoch、1400 步,出了一份 5.3G 的权重。后来又试 GPT-SoVITS,最后换成 IndexTTS-2.5——一条参考音就够,效果比前面两个都好,于是一直用到现在。
三个阶段都是真跑过的。页面上的样音和在线试用,跑的都是最后这一版。
三段说的是同一句英文:「Good evening sir, how are you? All systems are operational and the workshop is secure.」先听差别,再看后面为什么换。
Coqui XTTS-v2 原版权重,直接拿一段参考音念。
同样一条权重,用 300 句素材跑了 20 个 epoch、1400 步之后。
换成 IndexTTS-2.5,一条参考音,不训练。页面现在用的就是这版。
前两段是同一次微调的前后对比,第三段是后来换零样本方案生成的。三段都在本机生成,没有剪辑。
素材是 300 句英文,配好文本对照表,用 Coqui 官方的 XTTS 训练器跑。batch 是 4,梯度累积 4,训练 20 个 epoch、1400 步,最佳模型出现在第 675 步,最终权重 5.3G。单卡 5060 Ti,跑了一整轮。
听感确实比原版贴,但离电影里那个感觉还差一层,而且换个音色就得重训一次。后来试到 IndexTTS-2.5,一条参考音的效果就更好,我判断没必要继续训,于是停在这里。
为什么不公开这份权重:底座 XTTS-v2 是 CPML 许可,只允许非商用;训练素材是网上公开的 JARVIS 数据集,声音原型本身有版权。两者叠加,公开分发不合适。方法与流程我愿意分享,拿自己的声音录 300 句就能复现。
「零样本」的意思是:模型不需要为某一个声音重新训练。你给它一段几秒到几十秒的参考音频,再给它一句新的话,它就能用参考里的音色把这句话读出来。参考音频只决定「嗓子」,说什么由你写。
我在一台装了 RTX 5060 Ti 的机器上跑开源的 IndexTTS-2.5,推理在自己的机器上完成。现在复刻了两类声音:我的 AI 助手「贾维斯」的嗓子,以及电影《流浪地球》里 MOSS 的嗓子。合成一句话大概三到五秒。语言跟着文本走:写英文,贾维斯就用英文说;写中文,MOSS 就用中文说。
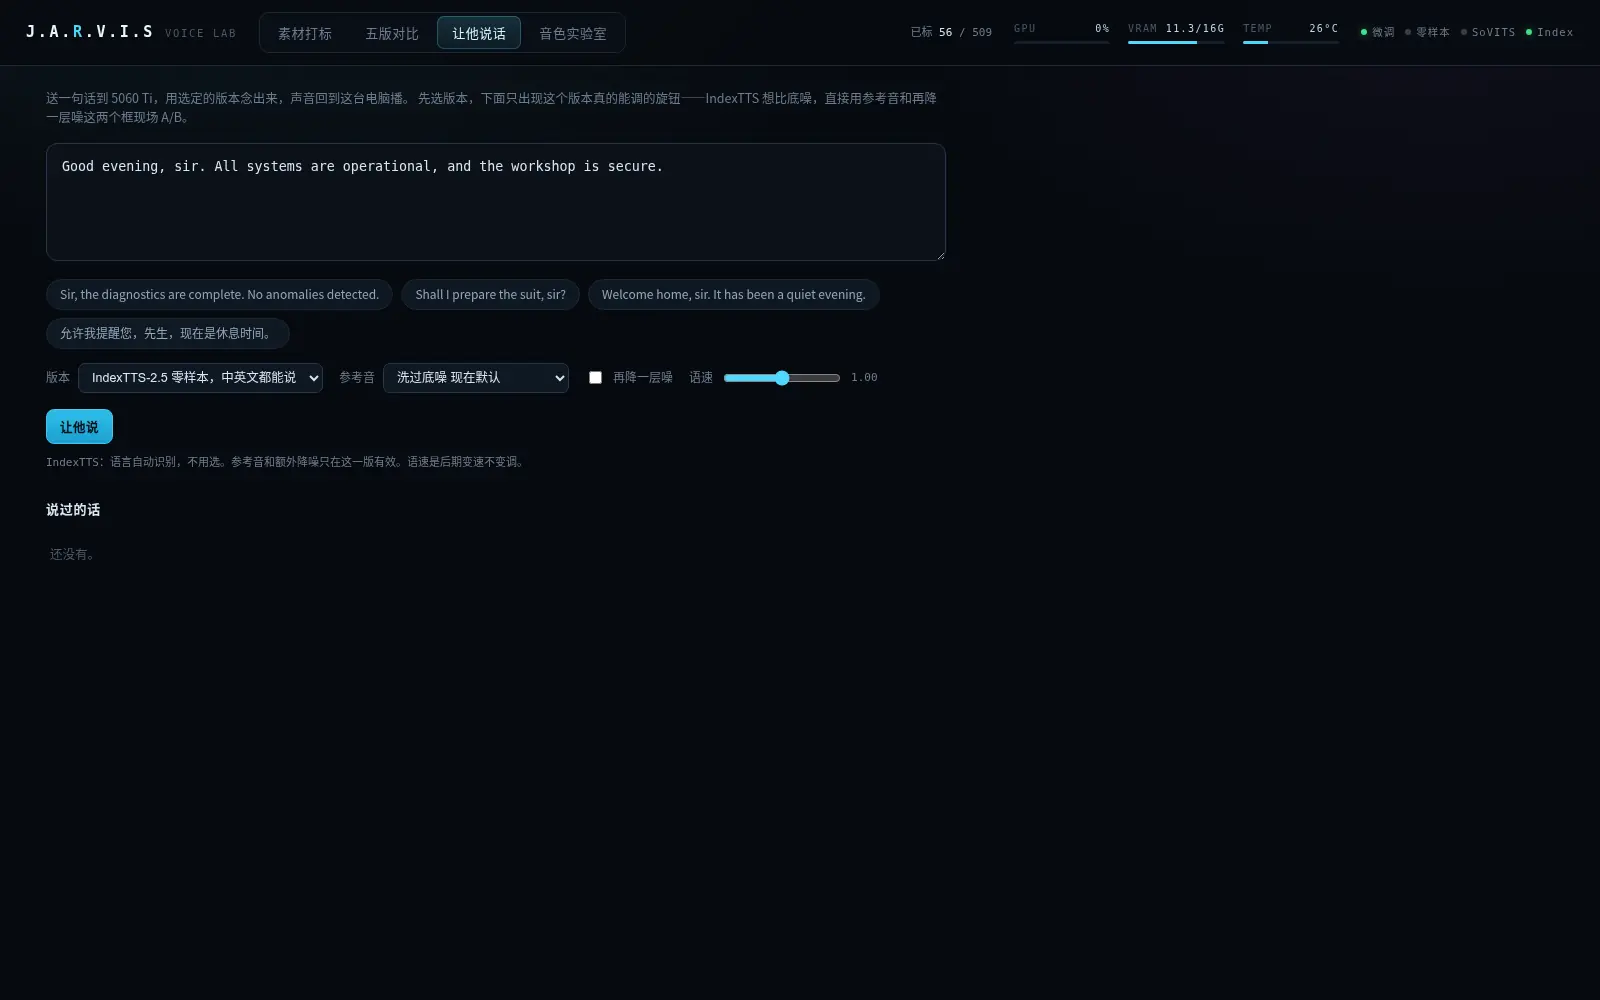
我的 AI 助手。英文句子写出来,用他的嗓子念。下面三段是这次新合成的,不是现成素材。
Good evening. The house is locked, the lights are off, and your first meeting tomorrow is at nine.晚上好。门已锁,灯已关,明天第一个会在九点。
The build passed. Three tests were skipped, and I left a note in the repository.构建通过了。跳过了三个测试,我在仓库里留了说明。
I have read the report. The short version: the numbers are good, but the timeline is not.报告读完了。简短版:数字不错,但时间表不行。
从电影公开片段克隆的声音。中文句子写出来,用它的嗓子念。同样,三段都是这次新合成。
从历史上看,文明的命运,取决于人类的选择。晚上好。所有系统运行正常。今天的实验数据已经备份,照明将在十分钟后关闭。我已经重新计算了所有可能的路径。只剩下一条,需要你们自己走完。日程、构建结果、长文摘要,用同一副嗓子读出来。
电影腔的旁白、系统播报、短视频配音。
换文本不用训练;换一条参考音,就是另一副嗓子。
这些是演示台词;声音由零样本克隆生成,不是电影原声。
两条候选参考音。同一段录音,两种处理方式;现在默认用干净版。
洗过底噪,现在是默认参考。
没洗底噪的原始录音,用来对比。
四条从电影公开片段里切出来的参考音。底噪、配乐和语速都不一样,合成出来的感觉也不同。
底噪最干净的一条,在线试用默认用它。
底下垫了配乐。
语速快,带点交流感。
情绪最冲的一条。
参考音只决定音色;上面六段演示都是另外合成的,不是从参考音里剪出来的。
这是一个个人技术实验。不是商业产品,也不是对外服务。页面上的音频都是已经生成好的静态文件,服务不在线时照样能听。
MOSS 的声音来自电影《流浪地球》的公开音频片段,仅用于个人技术研究,不用于商业用途。