Strata / Qwen3.8-Flash-Next
RTX 5060 Ti 上跑 125B 的 Qwen3.8-Flash-Next:16GB 显存、64K 上下文,实测解码 74–110 tok/s。
从零把引擎跑起来并做实测:选量化、配置专家缓存与上下文、用真实对话和长提示验证速度上限,记录这台机器的实际表现。
- 01LOAD
25.4 秒常驻
64 GB 的权重放在 SSD,引擎启动时按需映射;从零载入到可以回答只要 25.4 秒,之后一直在内存里等请求。
- 02CACHE
6,496 个专家留在显存
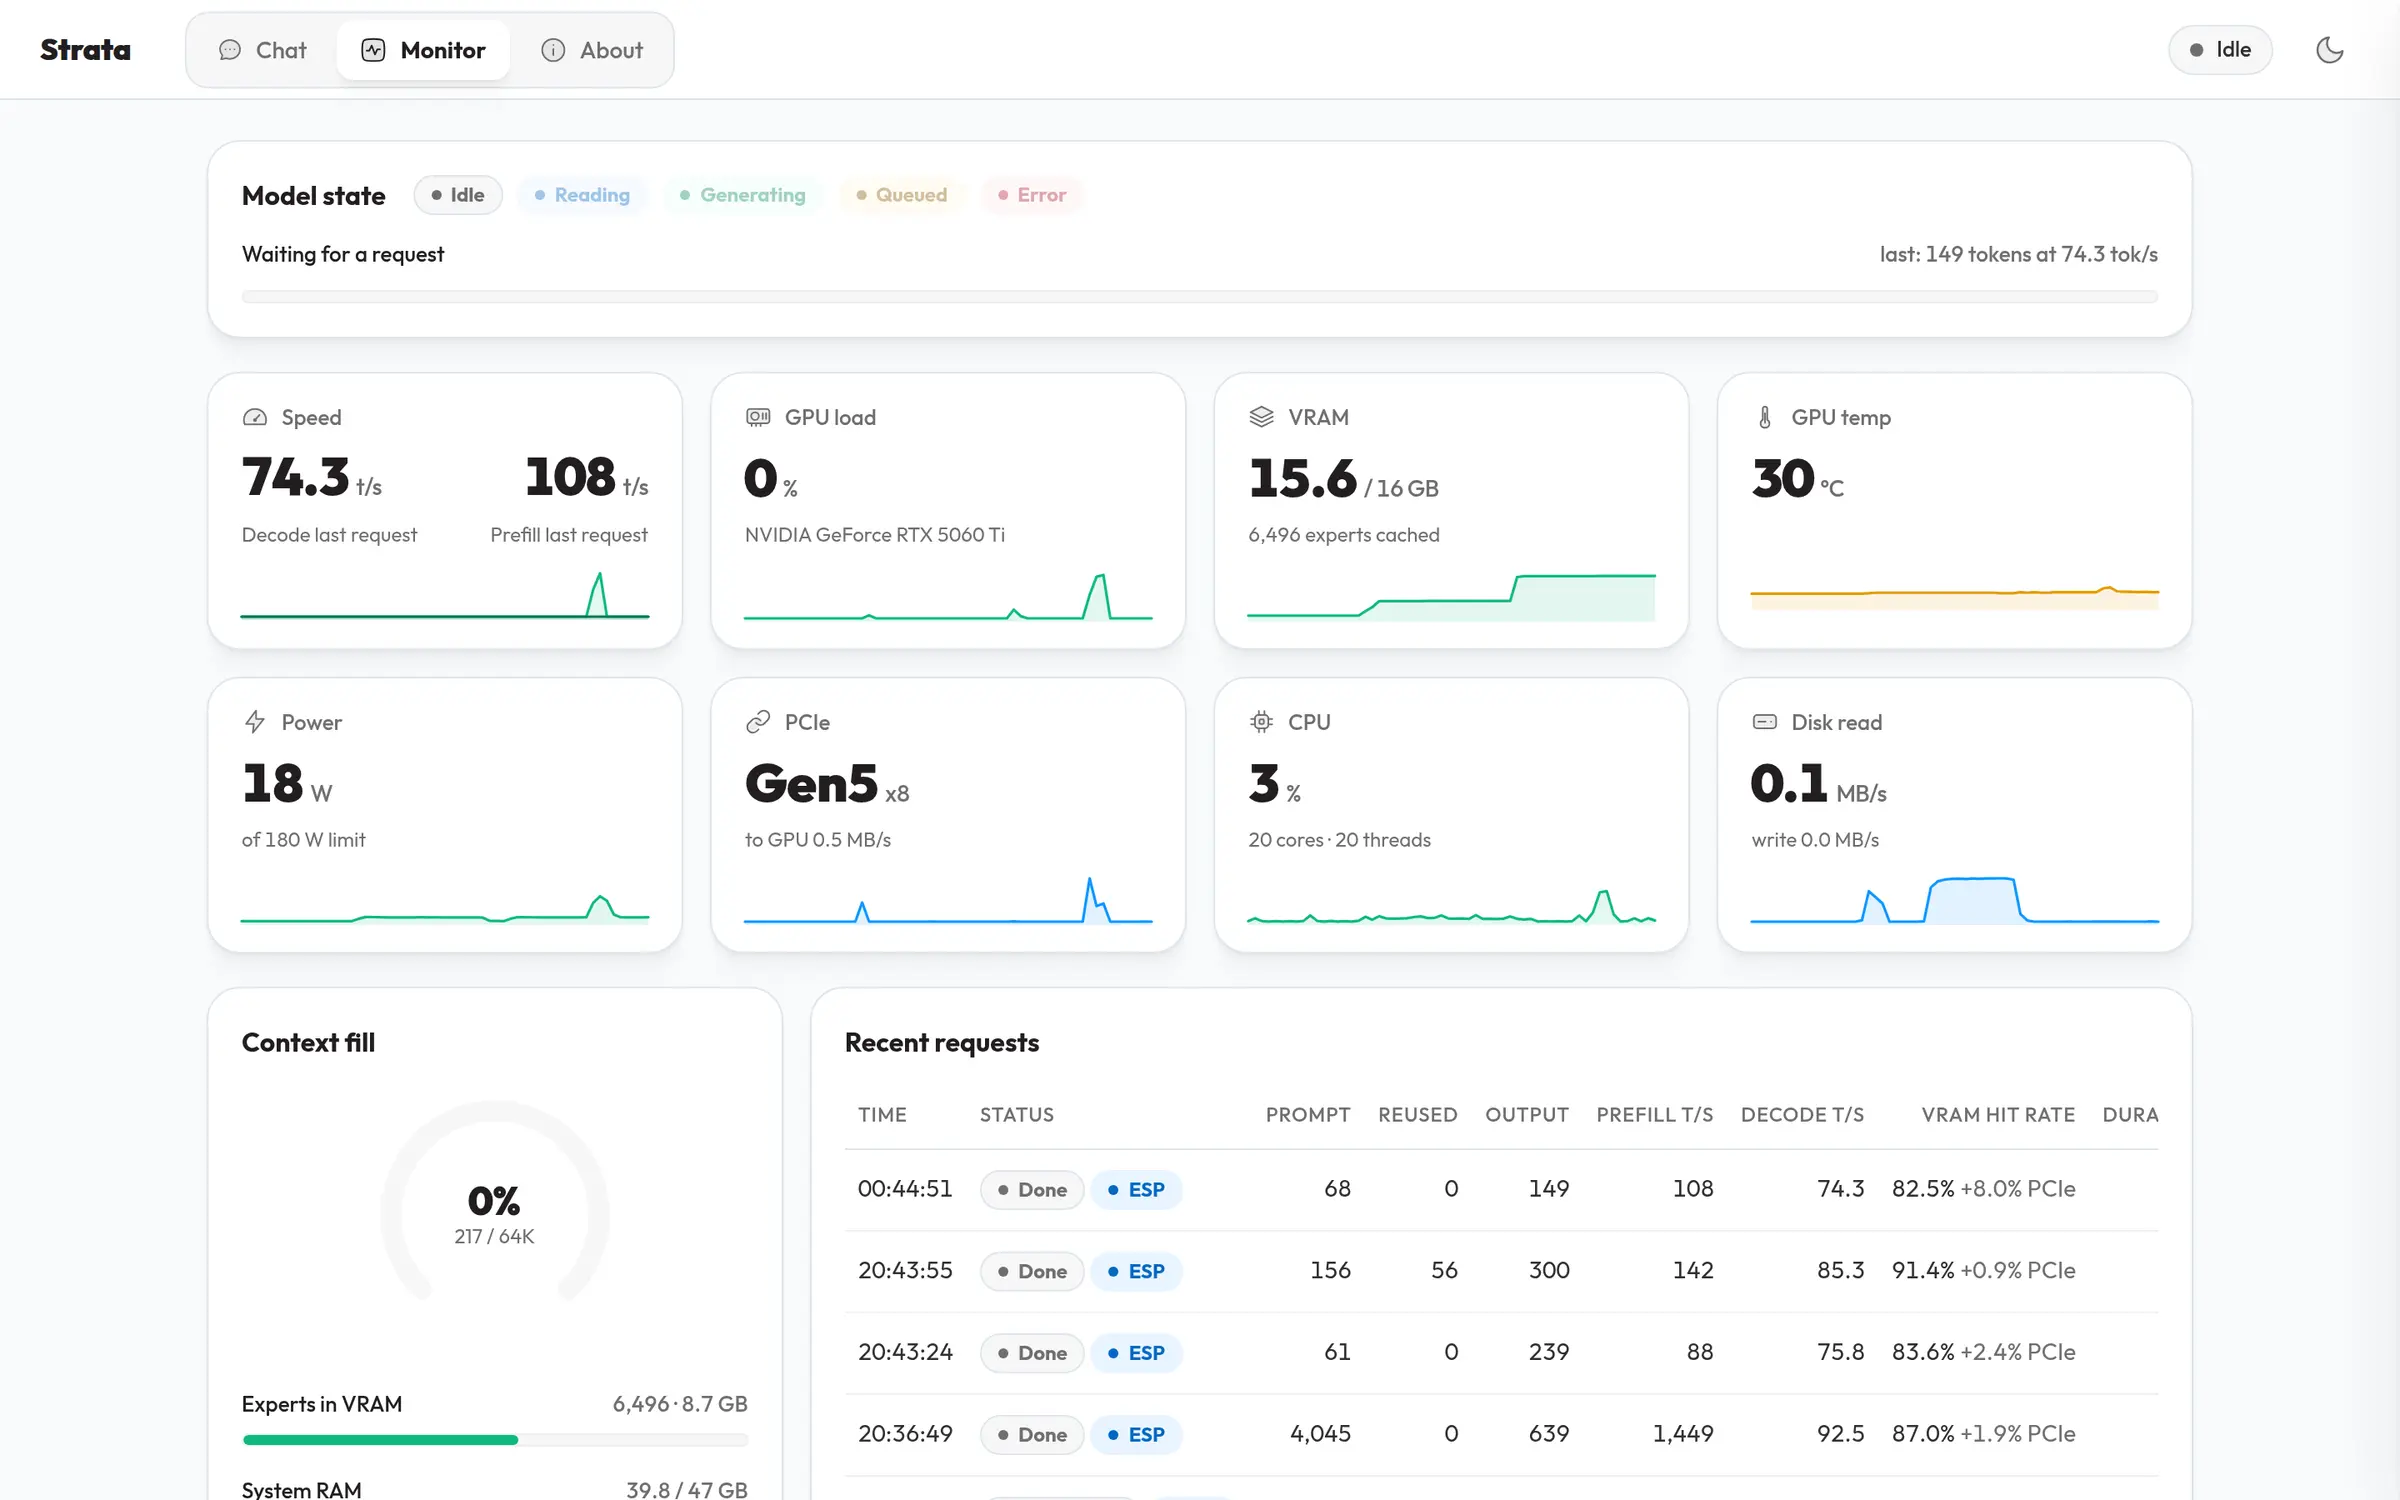
8.7 GB 的专家缓存命中率 82.5–91.4%,剩下的专家按请求经 PCIe Gen5 x8 取用,显卡每秒只搬几百 MB 到 1 GB 的量级。
- 03MEASURE
数字来自真实请求
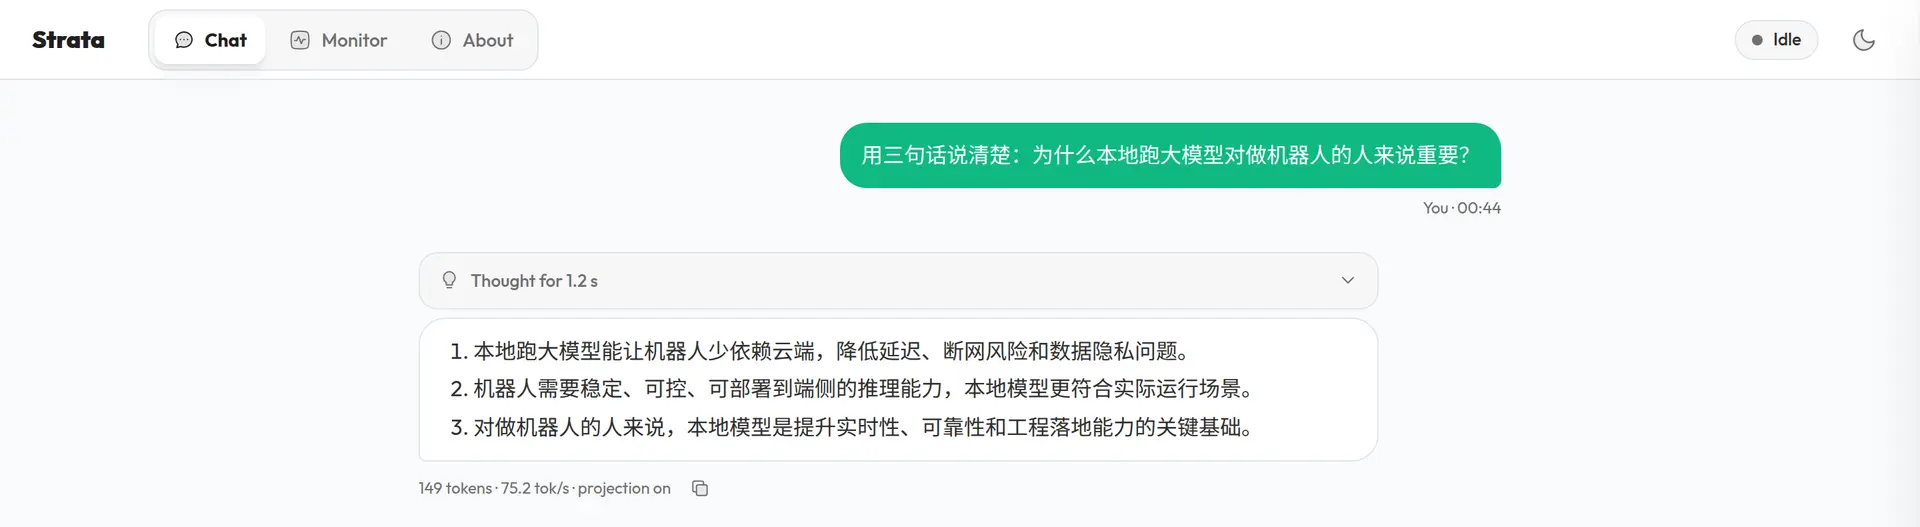
74.3 / 75.2 / 81.8 tok/s 是三次短回答,92.5–110.5 tok/s 是更长的几轮;这些写在 Monitor 面板里,不是跑分脚本的估算。
Strata 在一台 RTX 5060 Ti(16 GB 显存、47 GB 内存)的机器上把 Qwen3.8-Flash-Next 跑成本地服务。模型按 IQ2_XS 分成两个 GGUF(合计约 64 GB)放在 SSD 上;引擎常驻后,6,496 个专家(8.7 GB)留在显存里,每次请求只有约 8–17% 的专家需要经 PCIe Gen5 x8 临时取用,所以 16 GB 卡也能持续出字。
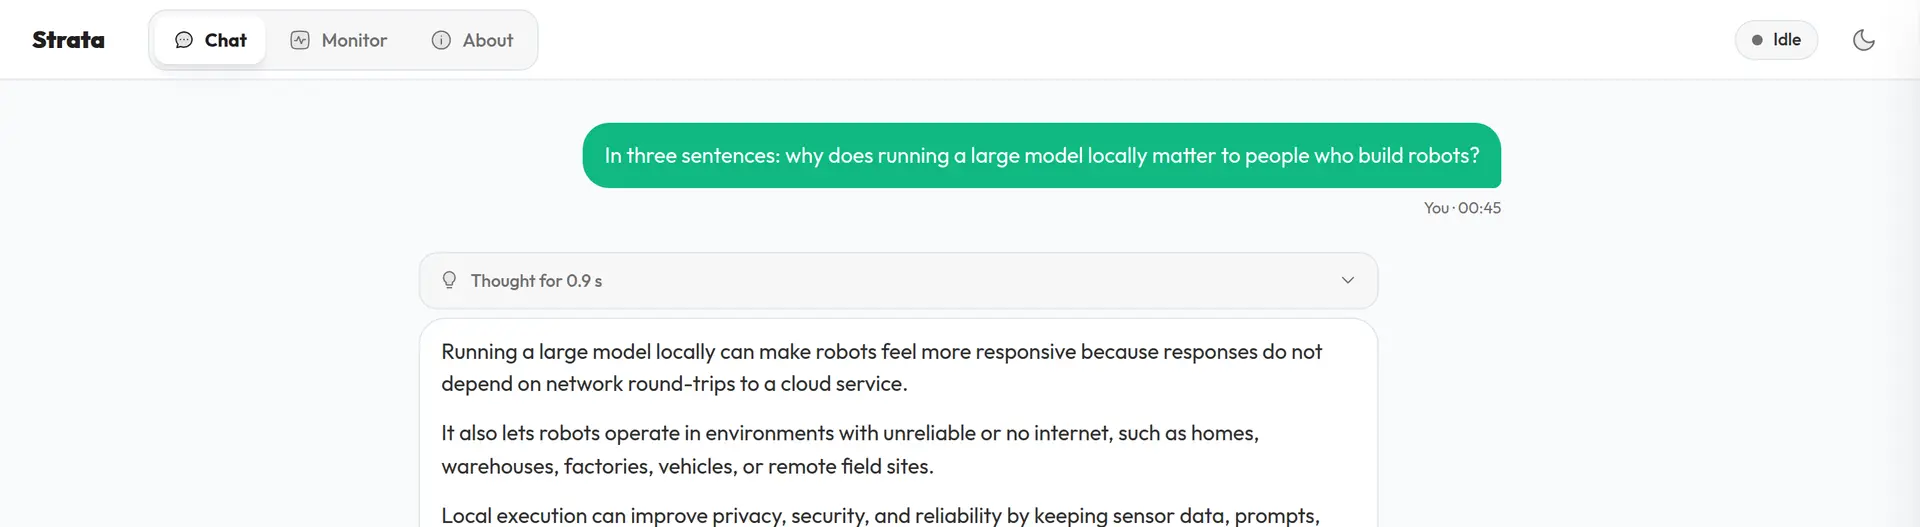
这几次真实会话的数字:引擎从零载入到可用 25.4 秒;中文短问答 149 tokens、75.2 tok/s;英文 148 tokens、81.8 tok/s;更长的几轮在 92.5–110.5 tok/s 之间。4,000 tokens 上下的长提示预填 1,091–1,449 tok/s。这些都是这台机器、这套量化下的实测,不当作其他硬件的普遍保证:换卡、换量化、换上下文长度,数字都会变。
这里记录的是具体项目与开发实践;实现状态、实验边界和硬件支持范围以来源仓库及当前代码为准。