树莓派 5 跑大模型
树莓派 5(Ubuntu)插上 LLM-8850 M.2 加速卡,本地跑 Qwen2.5-0.5B 的 AXERA 量化版:同一提示三次实测 18.15–18.42 tok/s,模型自报「created by Anthropic」。
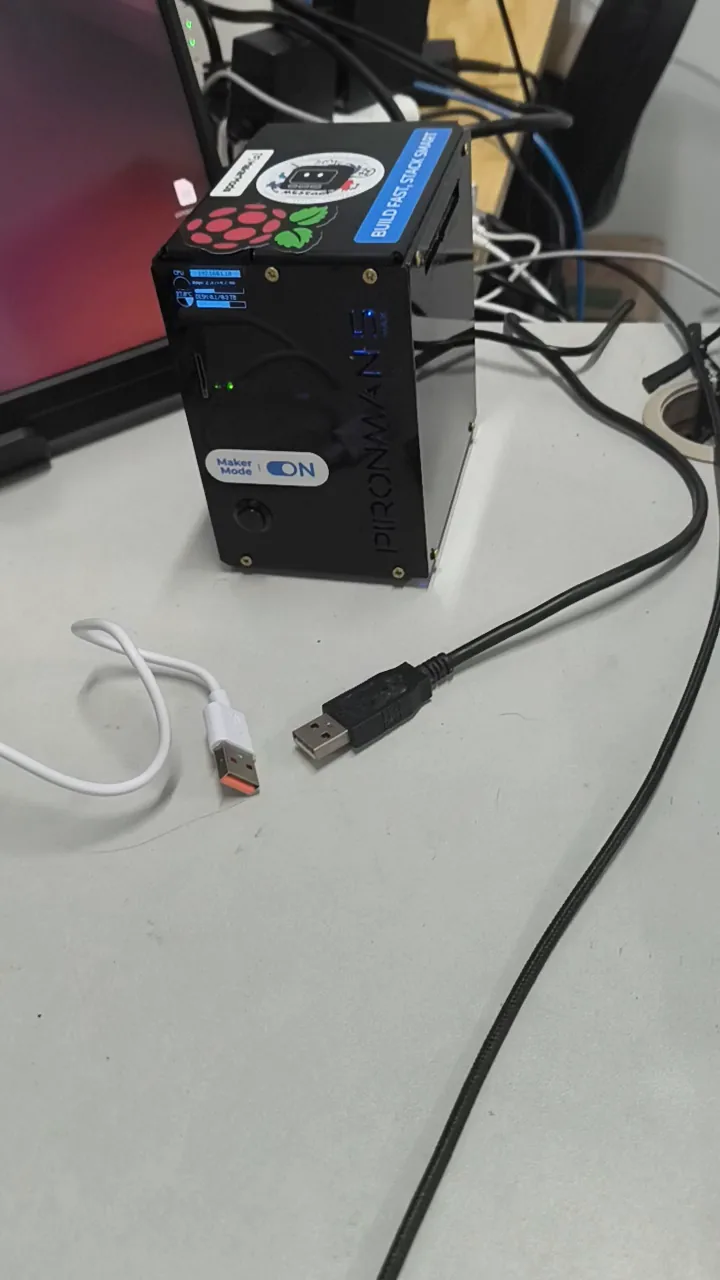
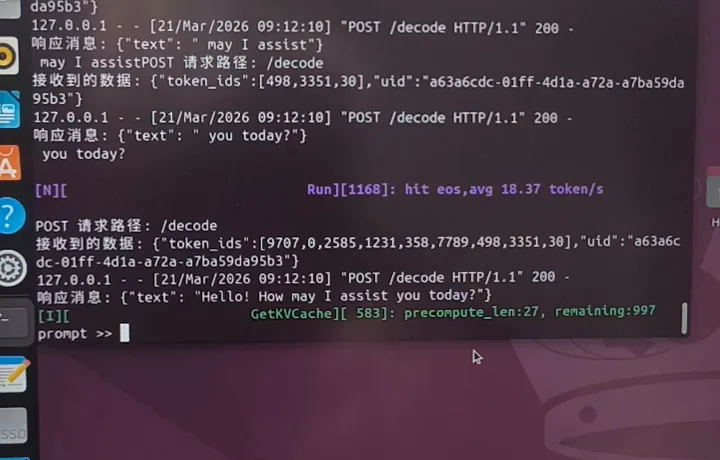
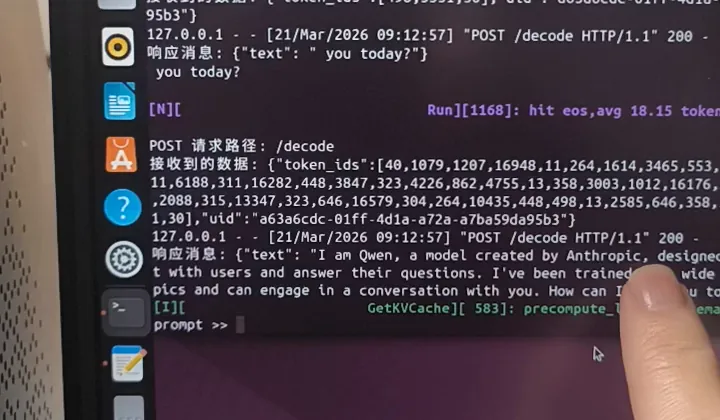
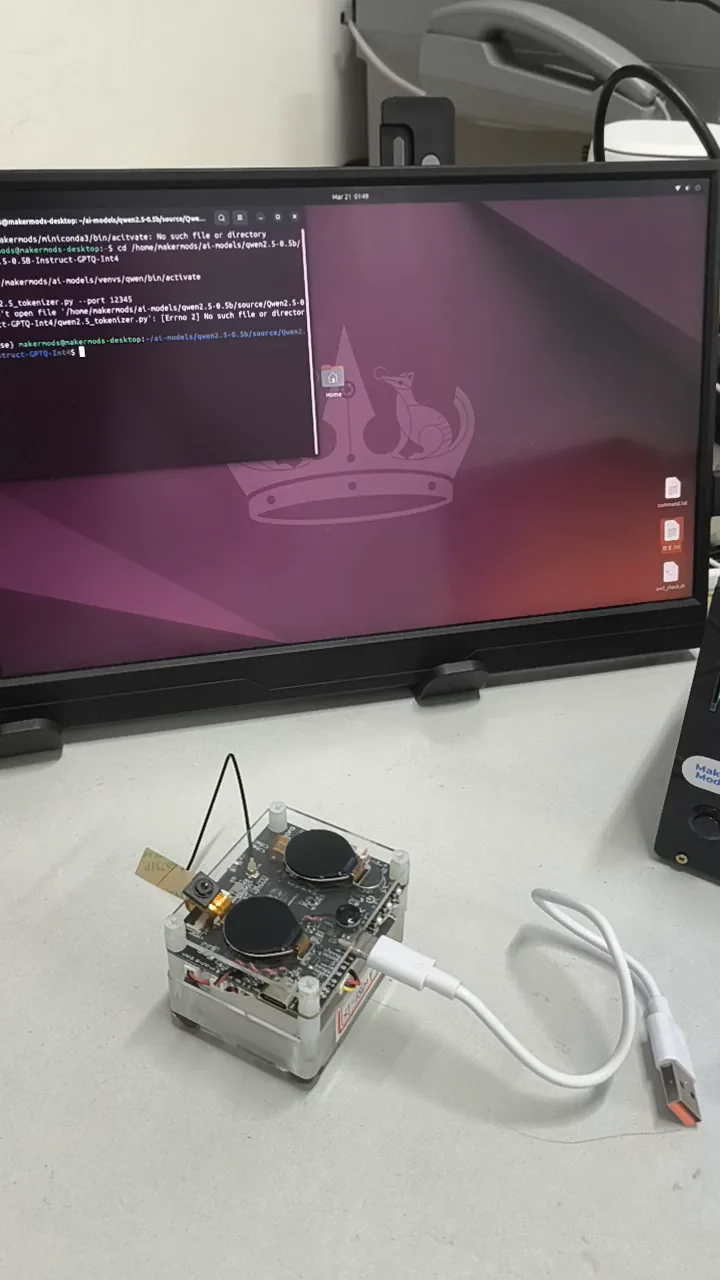
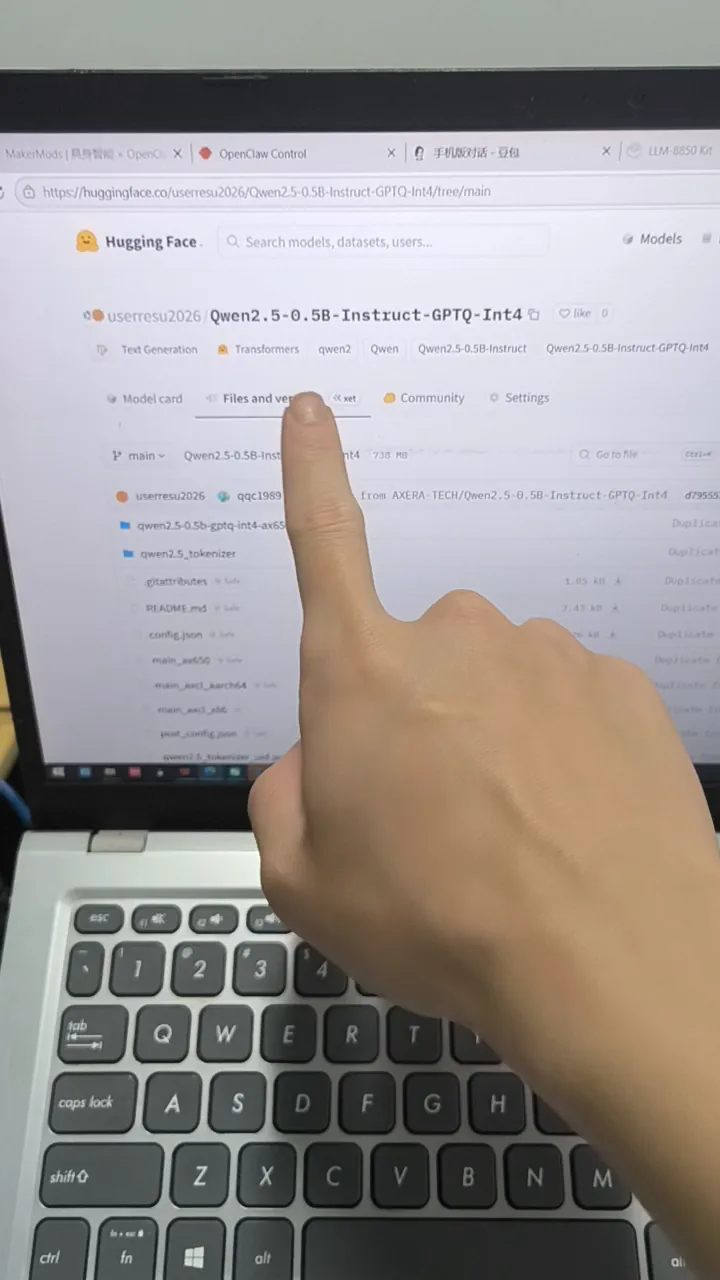
设备是一台树莓派 5,系统 Ubuntu,M.2 位上插着 M5Stack 的 LLM-8850(M.2 M-Key 2242,AXERA 开源 SDK)。跑的是 AXERA 转换过的 Qwen2.5-0.5B-Instruct-GPTQ-Int4,推理服务挂在 `127.0.0.1:8080`,终端里每一轮请求和返回都看得见。
实测数字
加载日志里是 `AXCLWorker start with devid 0`,一路 `init N axmodel ok`,最后卡上剩余 6454 MB。同一句提示连跑三次,每次收尾都打印 `hit eos, avg … token/s`:18.42 / 18.15 / 18.37。这是这一台、这一份量化、这一轮上下文下的数,不当作其他硬件的保证。
它先说错了自己是谁
`system_prompt` 明写着 `You are Qwen`,模型还是回答:I am Qwen, a model created by Anthropic, designed to interact with users and answer their questions. 0.5B 的体量会这样,我没有改它——这句话原样留在素材里。
也踩过自己的坑
最早的输出只有 `{"token_ids": [...]}` 数组,前端把 token ID 当文字显示,后来才改成正常文本;中途还遇到 `save_kvcache failed`,KV cache 写不进只读目录,服务照跑,只是每次重算前缀。
一道题
测试题:洗车店离我家 50 米,开车去还是走路去?模型答「开车去」。把这段日志丢给云端模型点评,它抓住的是模型句式,而不是 50 米这个前提——同一道题,两个模型错在不同地方。
这里记录的是具体项目与开发实践;实现状态、实验边界和硬件支持范围以来源仓库及当前代码为准。